| X |
前面出現 |
概 |
最少出現 |
概 |
最多出現 |
概 |
面為全同 |
概 |
| |
的次數 |
率 |
二次梅花 |
率 |
一次梅花 |
率 |
|
率 |
| (梅,梅) |
X=0 |
 |
X=2 |
|
X=0 |
|
X=1 |
|
| (梅,蘭) |
X=1 |
|
X=0 |
|
X=1 |
|
X=0 |
|
| (蘭,梅) |
X=1 |
|
X=0 |
|
X=1 |
|
X=0 |
|
| (蘭,蘭) |
X=2 |
|
X=0 |
|
X=1 |
|
X=1 |
|
我們這個表要說明同一個實驗,可以定義很多不同的函數-隨機變數。
綜合隨機變數的值和概率,我們可以有一種容易運用的概率函數。
上面表中的概率函數和累積概率分佈函數是:
| X |
P(X=x)=ai |
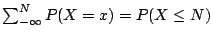 |
| 蘭面 |
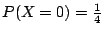 |
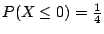 |
| 出現 |
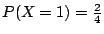 |
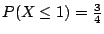 |
| 的次數 |
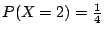 |
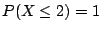 |
| 最少出現 |
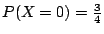 |
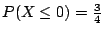 |
| 二次梅花 |
|
|
| 最多出現 |
|
|
| 一次梅花 |
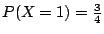 |
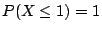 |
| 兩面 |
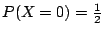 |
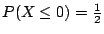 |
| 全同 |
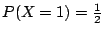 |
|
| |
概率函數 |
累積分佈函數 |
這裏的例子自然簡單一點,有時在複雜的實驗或煩瑣的要求時,
隨機變數和它的概率函數也相應的複雜起來,我們且不談這些技巧上的問題,
要指出的倒是:我們有成千上萬的隨機變數,每一個都有一個概率函數相隨,
每一個現象或要求可以計算出一個隨機變數出來,
只有滿足幾個簡單條件都可以過關了:
- (一)隨機變數的定義值是互不混淆的。
- (二)對每一個值都有一個0和1之間的概率函數值與之相對應:
- (三)隨機變數的累積分佈函數的最小值為0,最大值為1。即是
這幾條條件並不太難滿足,因此分佈函數多得很了。
我們回到原來問題想。到現在為止,進展是:我們要解釋一種社會現象,
首先假設可以有一個數學模型(概率空間)來滿足這個要求。為了方便計算,
把這模型用隨機變數這種方式寫出來。也就是說,我們先解答了隨機變數,
然後把這模型寫成為它的分佈函數。
因為社會現象如今可以假設它是一個分佈函數,
或這現象的單元服從某個隨機變數的概率(密度)函數。
(密度函數應用到連續型的隨機變數上面。)
解釋社會現象變為了解它相伴的分佈函數,也就是在這分佈函數中找到「測度」來。
社會現象很多,每一次要分析一個現象,再要重新研究它所相應而生的隨機變數和分佈函數,太麻煩了。
事實上,雖然隨機變數很多,但典型的分佈函數,供我們常用的不外二十個左右,
所以我們不妨先研究一下幾個有代表性的分配函數。以後碰到一個社會現象時,
只要把隨機變數類型認清楚,歸到某一典型的分佈函數,
我們便可以簡單利用已研究清楚的性質和定理了。
典型的分佈函數是
-
- (一)二項分佈函數:(有限離散型)
凡隨機變數有二分型的特性;事件出現的方法非此即彼,非甲即乙,非善即惡……時,
都是屬於這一類的分佈函數。它的概率函數是
- (二)無限離散型;波爾松型:
凡隨機變數滿足一些條件:
-
- (1)事件發生的概率與(時間)區間長短有關,而與開始或結束地點無關。
- (2)現在發生之事件跟過去事件或未來事件無關。
- (3)短時期內只出現一簡單事件的概率和區間長度成比例。
- (4)短時間內出現多過一簡單事件機會很少。
在這些條件之下,出現了一個波爾松型隨機變數它的概率函數是,
- (三)連續型;常態分佈函數:
當樣本數很大,隨機變數所取的值為很多時,適當變換後,有一個理想型的分佈函數出現:
在普通情形中,大多隨機變數可用這三類型來代表。自然也可以進一步學多幾個不同類形的隨機變數。
如卡方分佈、幾何分佈、Student 分佈
|


